La forma en que una empresa prepara sus documentos antes de enviarlos a un modelo de IA puede tener un impacto directo en los costos, el rendimiento y la confiabilidad de sus proyectos. La clave no está solamente en elegir un modelo más eficiente, sino en construir una arquitectura capaz de entregarle a la IA únicamente la información que necesita.
La inteligencia artificial empresarial está avanzando a paso firme: asistentes y agentes capaces de consultar información, ejecutar acciones y participar de procesos completos de negocio. Pero a medida que estas iniciativas escalan, aparece una pregunta cada vez más relevante para CIOs, CTOs y responsables de transformación digital: ¿cuánto cuesta realmente cada interacción con la IA y qué parte de la información que estamos procesando aporta valor?
El problema se vuelve especialmente evidente al trabajar con documentos como facturas, órdenes de compra, remitos o formularios en PDF.
Un PDF puede parecer un documento simple para una persona. En cambio, un sistema de IA puede contener texto, imágenes, logotipos, códigos QR, información de formato, coordenadas, metadatos y elementos visuales que no necesariamente son relevantes para la tarea que se quiere resolver.
Si toda esa información se envía directamente a un modelo, la IA tiene que procesarla antes de identificar lo que realmente importa.
Y ahí aparece un desafío que suele quedar en segundo plano: la eficiencia de tokens IA no depende únicamente del modelo utilizado, sino también de la calidad y estructura de los datos que llegan hasta él.
El PDF no es el dato
Para una persona, leer una factura y encontrar el número de comprobante, el CUIT del proveedor o el importe total puede ser una tarea sencilla.
Para una arquitectura tecnológica, el desafío es diferente.
Antes de que un agente pueda utilizar esos datos, hay que resolver cuestiones como:
- ¿Dónde está cada dato dentro del documento?
- ¿El PDF tiene información duplicada?
- ¿Hay imágenes o elementos gráficos que no aportan al proceso?
- ¿El formato cambia según el proveedor?
- ¿Los campos están siempre en la misma posición?
- ¿El documento contiene información que debe ser validada antes de ingresar al ERP?
- ¿Qué ocurre cuando falta un dato o aparece en un formato inesperado?
Enviar el PDF completo a un modelo de lenguaje puede resolver parte del problema, pero no necesariamente es la arquitectura más eficiente.
La alternativa es procesar el documento antes de exponerlo a la IA, separando la extracción de información estructurada de aquellos casos en los que realmente hace falta utilizar capacidades de inteligencia artificial.
Este enfoque permite reservar el procesamiento más costoso para donde aporta verdadero valor.
La arquitectura importa tanto como el modelo
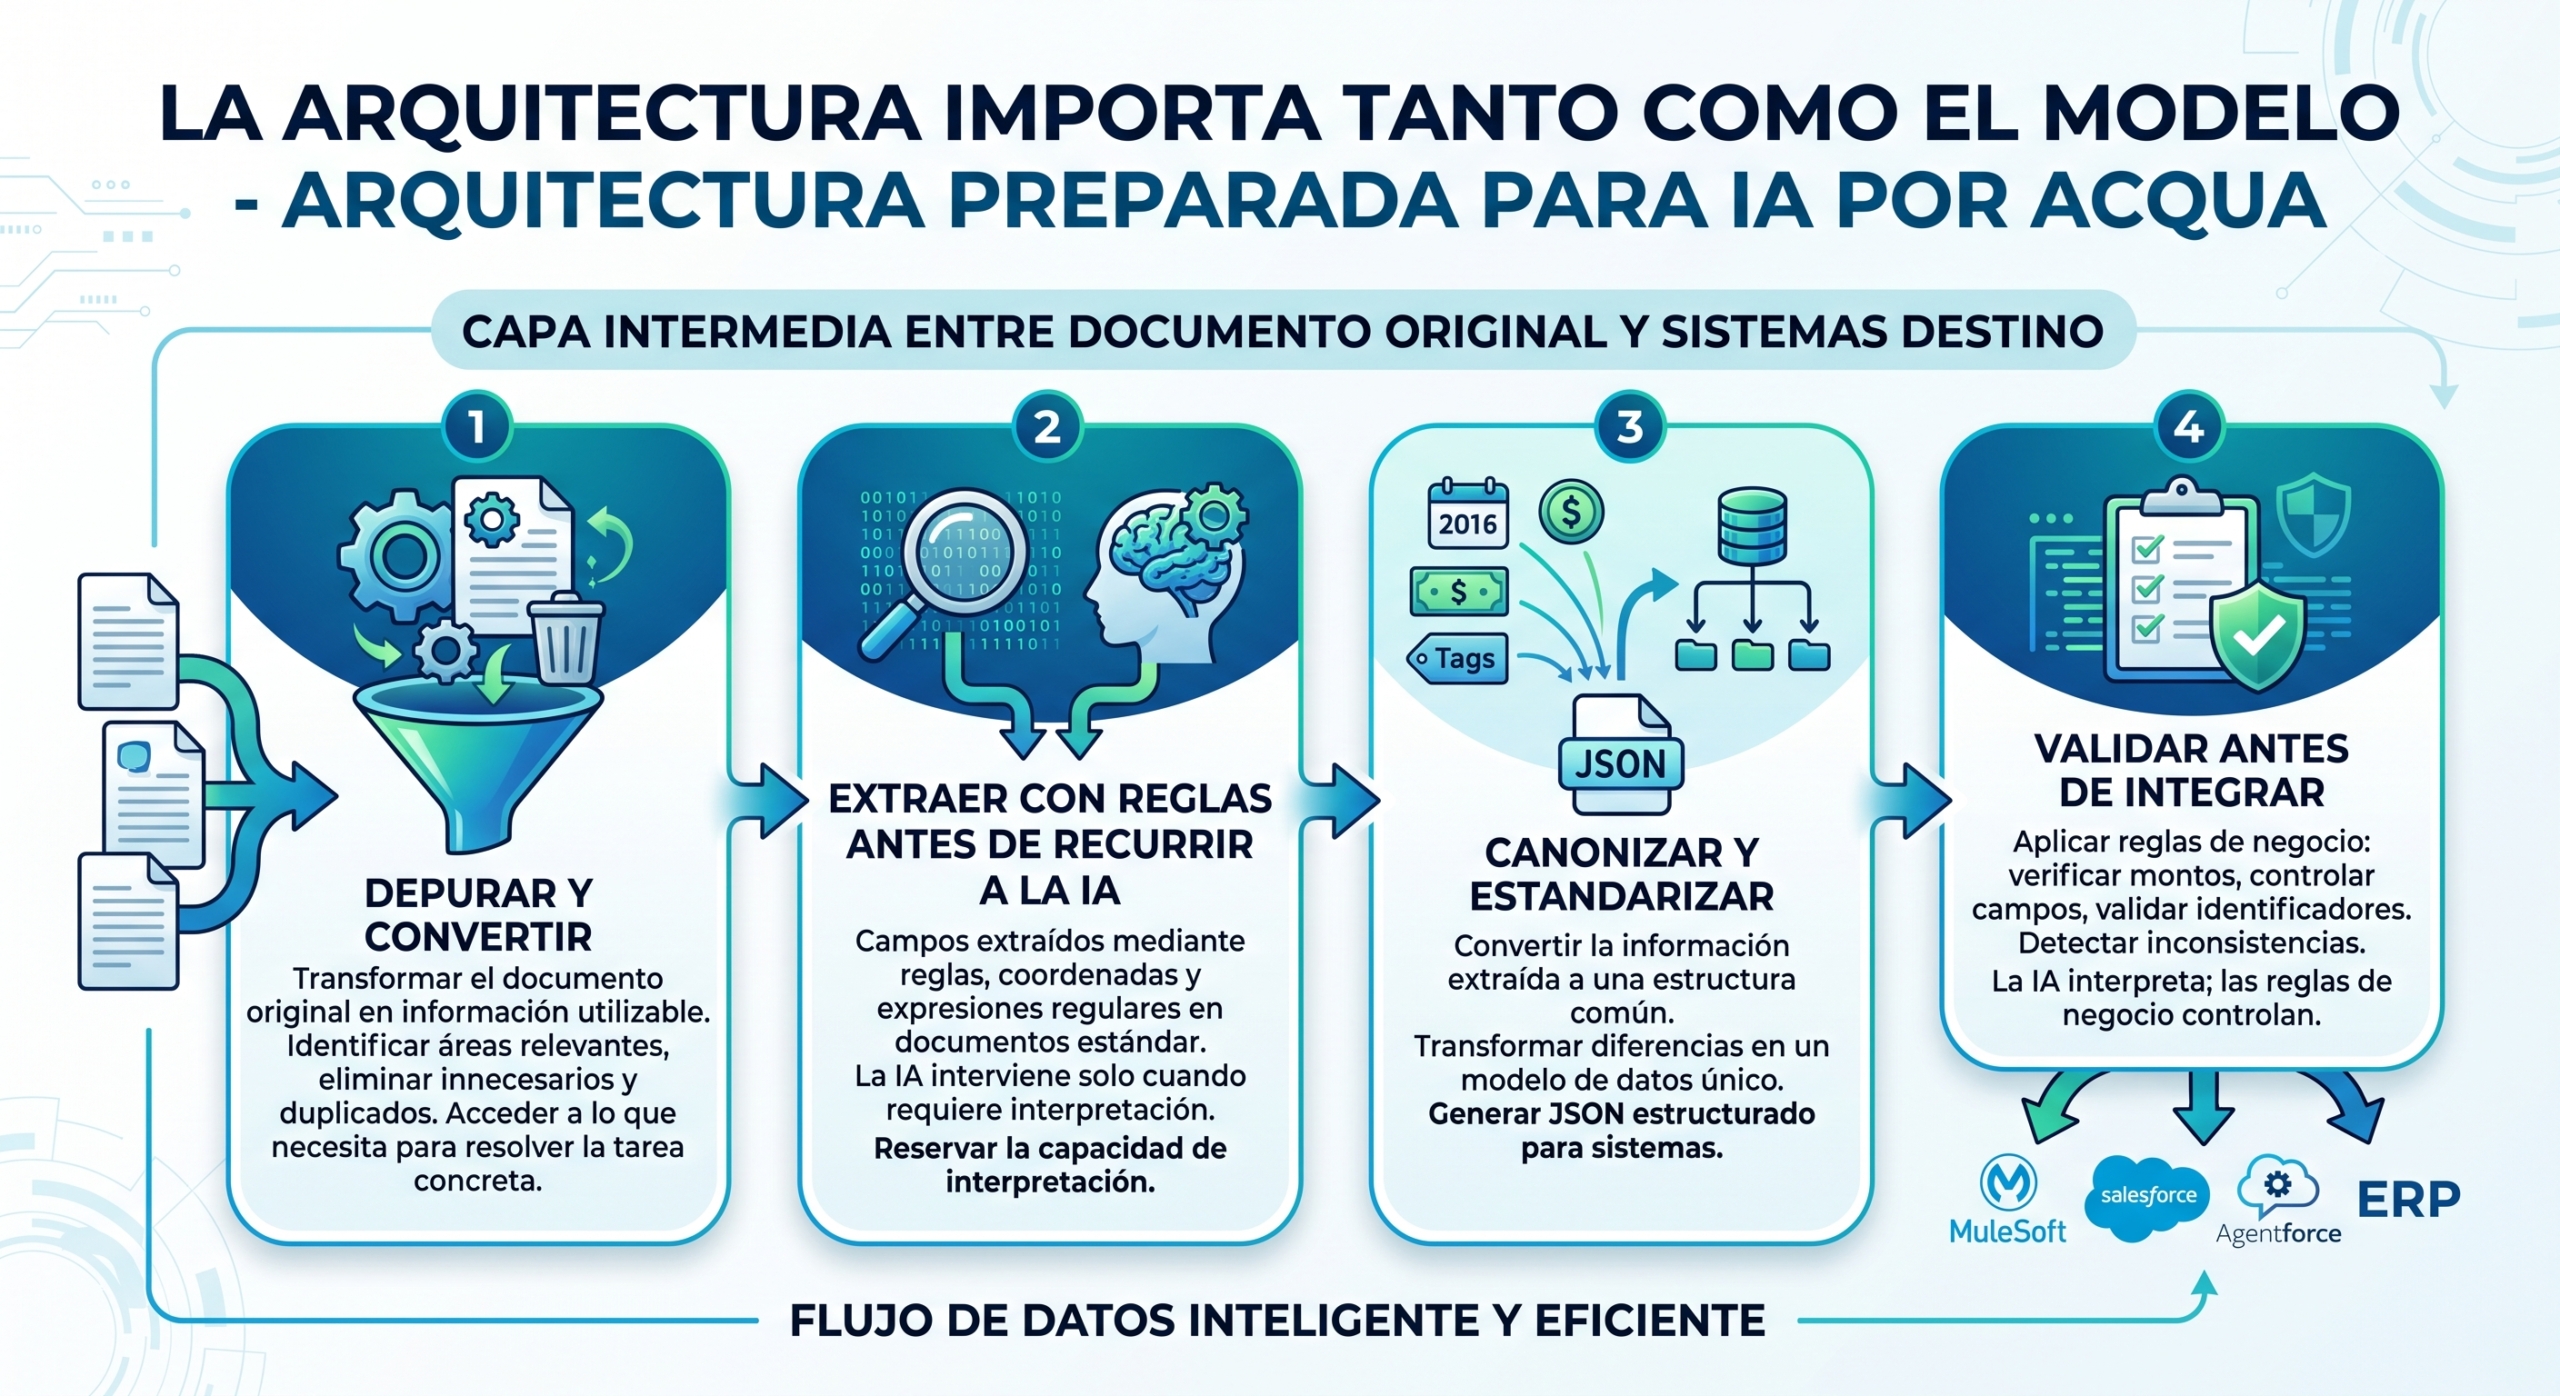
Una arquitectura preparada para IA debería incorporar una capa intermedia entre el documento original y los sistemas que finalmente utilizarán la información.
El flujo puede dividirse en cuatro etapas.
-
Depurar y convertir
El primer paso consiste en convertir el documento original en información utilizable.
En lugar de enviar el PDF completo, se identifican las áreas relevantes, se eliminan elementos innecesarios y se detectan posibles duplicados.
El objetivo no es que la IA “vea todo”, sino que pueda acceder a lo que necesita para resolver una tarea concreta.
-
Extraer con reglas antes de recurrir a la IA
No todos los datos necesitan inteligencia artificial.
En documentos que siguen patrones conocidos, determinados campos pueden extraerse mediante reglas, coordenadas, expresiones regulares o estructuras predefinidas.
Esto permite que la IA intervenga únicamente cuando surge una situación que realmente requiere interpretación.
“La IA no debería utilizarse para leer líneas repetitivas de un documento estándar si una regla puede resolverlo. El objetivo es reservar la capacidad de interpretación para los casos en los que realmente aporta valor.”
Este principio es especialmente relevante en arquitecturas que combinan automatización, integración y agentes inteligentes.
-
Canonizar y estandarizar
Una vez extraída la información, el siguiente paso es convertirla a una estructura común.
Por ejemplo, distintos proveedores pueden utilizar diferentes formatos para representar fechas, monedas, números de factura o códigos de producto. La arquitectura debe transformar esas diferencias en un modelo de datos único.
El resultado puede ser un JSON estructurado y estandarizado, preparado para ser consumido por otros sistemas.
Así, MuleSoft, Salesforce, Agentforce o un ERP no necesitan interpretar cada PDF desde cero: reciben información que ya fue procesada y normalizada.
-
Validar antes de integrar
La extracción tampoco debería implicar ingreso automático.
Antes de enviar la información al sistema de destino, pueden aplicarse reglas de negocio: verificar montos, controlar la presencia de determinados campos, validar identificadores de proveedores o detectar inconsistencias.
Solo cuando la información cumple las condiciones definidas se dispara la integración con el ERP, CRM u otra aplicación.
La lógica es sencilla: la IA interpreta; las reglas de negocio controlan.
La arquitectura importa tanto como el modelo
¿Dónde entra Agentforce?
En una arquitectura de este tipo, Agentforce no necesita convertirse en un lector universal de documentos.
Puede trabajar sobre información previamente estructurada y conectada con el resto del ecosistema empresarial.
Salesforce plantea justamente el concepto de grounding: conectar los agentes con información relevante y confiable para mejorar la calidad de sus respuestas y acciones. Agentforce puede trabajar con datos estructurados, documentos y fuentes externas, mientras que MuleSoft actúa como capa de integración para conectar agentes con sistemas y APIs empresariales.
Esto cambia la pregunta.
No se trata solamente de preguntarse “¿qué modelo de IA podemos utilizar?”, sino también: ¿Qué información debería llegar al modelo, en qué formato y bajo qué reglas?
El costo de la IA también se diseña
Cuando una iniciativa pasa de una prueba de concepto a cientos o miles de documentos procesados, pequeñas ineficiencias pueden multiplicarse.
Por eso, optimizar el consumo de tokens no debería considerarse una tarea posterior para reducir costos cuando el proyecto ya está en producción. Tiene que formar parte de la arquitectura desde el comienzo.
La lógica es similar a la de cualquier otra infraestructura tecnológica: no tiene sentido utilizar recursos de procesamiento para información que puede descartarse antes de llegar al sistema.
Además, la eficiencia no es solamente económica.
Una arquitectura de datos bien diseñada también facilita la trazabilidad, la integración y el control sobre la información que utilizan los agentes.
McKinsey señala que, a medida que las empresas buscan escalar sus iniciativas de IA, la preparación de los datos aparece como una de las principales restricciones. El desafío consiste en conectar datos estructurados y no estructurados en una base de datos gobernada y reutilizable que permita a los agentes operar con información confiable.
Menos información para la IA, más información útil
La eficiencia de tokens IA no consiste simplemente en enviar menos datos.
Consiste en enviar mejores datos.
Un documento de diez páginas no necesariamente requiere que un modelo procese diez páginas. Una factura no requiere que un agente vuelva a interpretar el logotipo del proveedor cada vez que debe identificar un importe. Y un dato que puede obtenerse mediante una regla determinística no necesita necesariamente una consulta a un modelo generativo.
La arquitectura debe decidir qué información se extrae, cuál se descarta, cuál se valida y en qué momento tiene sentido recurrir a la IA.
Ese enfoque también ayuda a construir sistemas más gobernables. En entornos empresariales, donde los agentes pueden interactuar con información sensible y ejecutar acciones sobre otros sistemas, los controles de acceso, las reglas y la trazabilidad son parte fundamental del diseño. Salesforce, por ejemplo, incorpora mecanismos de grounding, controles de acceso, auditoría y guardrails dentro de su arquitectura de Agentforce.
La IA eficiente empieza antes del modelo
El crecimiento de la IA empresarial está llevando a las organizaciones a pensar cada vez menos en la inteligencia artificial como una herramienta aislada y más bien como una capa integrada en su arquitectura tecnológica.
En ese contexto, la eficiencia de tokens IA es también una cuestión de arquitectura de datos.
La diferencia entre una implementación costosa y una escalable puede estar en lo que sucede antes de que la información llegue al modelo: cómo se extrae, cómo se estructura, cómo se valida y cómo se integra con los sistemas existentes.
Porque una IA más inteligente no siempre necesita procesar más información.
Muchas veces necesita recibir menos información, pero mejor preparada.
¿Tu arquitectura está preparada para escalar con IA? En Acqua IT ayudamos a las organizaciones a analizar cómo circulan sus datos, identificar oportunidades de optimización y diseñar arquitecturas que integren datos, sistemas e inteligencia artificial de manera eficiente.
Solicita un Diagnóstico de Arquitectura de Datos e IA escribiendo a [email protected]