ACQUA IT desarrolló DOCK-IA, una plataforma inteligente para automatizar el procesamiento de documentos corporativos mediante una arquitectura híbrida que combina reglas de extracción, inteligencia artificial selectiva, validación de datos e integración con sistemas empresariales.
La inteligencia artificial abrió nuevas posibilidades para automatizar tareas que durante años dependían de la carga y la revisión manuales. Entre ellas, el procesamiento de facturas, órdenes de compra, remitos y otros documentos que forman parte de los procesos administrativos de las empresas.
Sin embargo, automatizar no significa necesariamente enviar cada documento completo a un modelo de inteligencia artificial.
Los archivos PDF pueden contener imágenes, logotipos, códigos QR, información de formato y otros elementos que no siempre son relevantes para la extracción de los datos que necesita un sistema empresarial.
Cuando estos documentos se procesan íntegramente mediante modelos de lenguaje, el volumen de información analizada puede crecer rápidamente y, con él, el consumo de tokens y los costos asociados.
El desafío, entonces, no consiste solamente en incorporar IA a un proceso documental, sino en definir qué información necesita realmente la inteligencia artificial y en qué momento debe intervenir.
Para organizaciones que procesan grandes volúmenes de comprobantes, esta diferencia puede ser determinante a la hora de construir una automatización escalable y con costos previsibles.
¿Qué es DOCK-IA y qué problema resuelve?
Para abordar este desafío, ACQUA IT desarrolló DOCK-IA, una plataforma de automatización documental que combina un motor de reglas con inteligencia artificial para extraer, validar y estructurar información proveniente de documentos corporativos.
Su principal diferencial está en la forma en que distribuye el trabajo entre ambas tecnologías.
En lugar de utilizar IA para interpretar cada documento de principio a fin, DOCK-IA utiliza inteligencia artificial de manera estratégica durante la configuración de las reglas de extracción y como mecanismo de respaldo cuando un documento presenta una excepción que no puede resolverse mediante las reglas existentes.
Una vez configurada una plantilla, el procesamiento habitual queda a cargo del motor de reglas. Esto permite que los documentos que responden a estructuras conocidas puedan procesarse sin enviar todo su contenido a un modelo de IA.
Cuando aparece una situación particular —por ejemplo, un cambio de diseño, una ubicación inesperada de un dato o una estructura heredada— entra en juego el Targeted AI Fallback, que utiliza IA únicamente sobre el sector que necesita una interpretación adicional.
El resultado es una arquitectura en la que las reglas realizan el procesamiento repetitivo y la IA interviene donde realmente agrega valor.
La visión del CTO: IA para configurar, reglas para procesar
Javier Godino, Director de Tecnología (CTO) de ACQUA IT y responsable de la arquitectura de DOCK-IA, explica el problema que dio origen a la solución:
“Este producto nació con la idea de resolver un problema recurrente en las empresas: la extracción de documentos metiendo los PDFs directo a la IA. El procesamiento directo de PDFs puede generar un consumo elevado de tokens porque los archivos contienen información que no necesariamente es relevante para la extracción. Por eso decidimos no utilizar la IA para procesar diariamente el documento completo, sino aprovecharla en la configuración y recurrir a ella de manera puntual cuando aparece una excepción.”
El enfoque permite, además, mantener una arquitectura agnóstica respecto del modelo de IA. Esto significa que DOCK-IA puede integrarse con distintos modelos de lenguaje sin construir toda la solución alrededor de un único proveedor tecnológico.
De esta manera, la inteligencia artificial deja de ser el único mecanismo de procesamiento y pasa a formar parte de una arquitectura más amplia, diseñada alrededor del proceso de negocio.
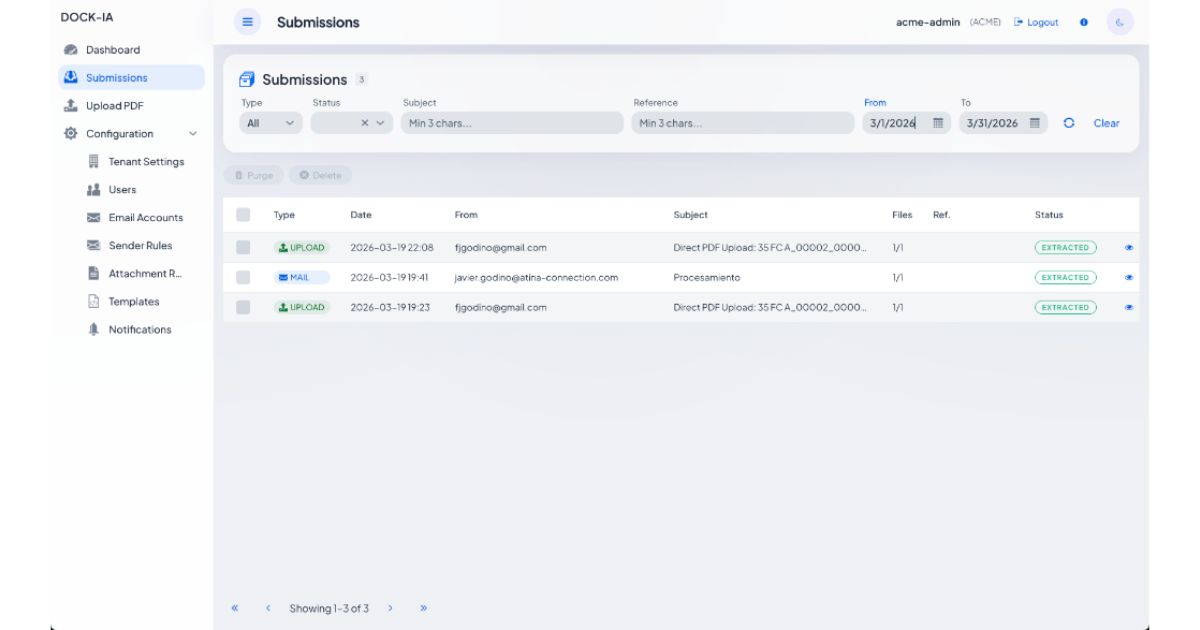
Del documento al dato: cómo funciona DOCK-IA
Para que un documento pueda convertirse en información útil para un ERP, CRM u otro sistema corporativo, primero es necesario extraer los datos relevantes, estructurarlos y validarlos.
DOCK-IA organiza este proceso en diferentes etapas:
- Recepción multicanal
Los documentos pueden ingresar desde casillas de correo electrónico, portales de proveedores, APIs o cargas manuales, en formatos como PDF o CSV. - Conversión y preparación
El sistema prepara el contenido para su procesamiento y elimina elementos que no son necesarios para la extracción de información. - Extracción dirigida
El documento se divide en bloques relevantes —como cabecera, detalle, impuestos o totales— y se aplican reglas específicas para identificar cada dato en su contexto.
Cuando una estructura no puede resolverse mediante las reglas configuradas, se puede activar el Targeted AI Fallback para analizar puntualmente esa excepción, en lugar de procesar nuevamente el documento completo.
- Estructuración
La información extraída de documentos con formatos diferentes se transforma en una estructura uniforme, por ejemplo, mediante JSON, para facilitar su utilización por otros sistemas. - Validación
Antes de enviar los datos a los sistemas transaccionales, se aplican controles de consistencia. Pueden contemplarse verificaciones sobre montos, totales, CUIT, CAE y otras reglas definidas según el proceso. - Integración
Una vez validada, la información puede enviarse mediante APIs y webhooks hacia sistemas como SAP, JD Edwards, Oracle o plataformas como Salesforce, utilizando una arquitectura de integración acorde a las necesidades de cada organización.
Así, el proceso deja de ser simplemente “leer un PDF” y pasa a ser una cadena controlada de extracción → validación → estructuración → integración.
Seguridad, soberanía del dato y trazabilidad
La automatización documental también plantea una pregunta fundamental: ¿dónde quedan los documentos y quién controla la información que contienen?
En procesos que involucran facturas, órdenes de compra, información de proveedores o documentación financiera, la seguridad debe formar parte de la arquitectura desde el inicio.
DOCK-IA permite trabajar con infraestructura de almacenamiento del propio cliente, como contenedores Amazon S3, para mantener el control sobre dónde se alojan los documentos y cómo se gestionan.
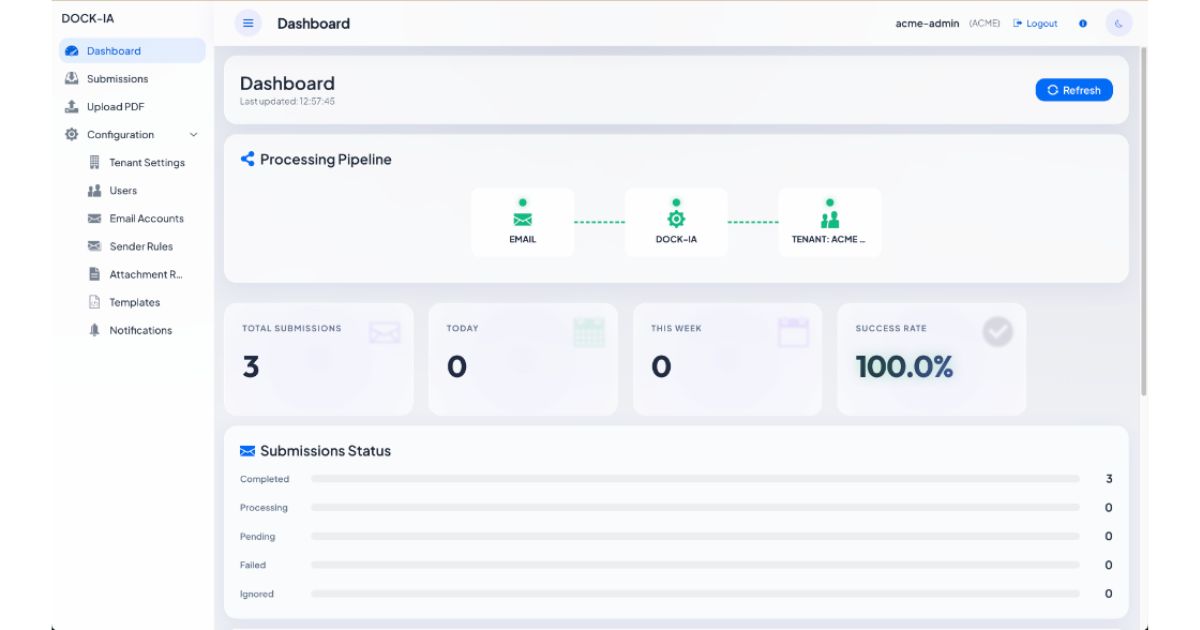
La plataforma también incorpora mecanismos de trazabilidad para supervisar el procesamiento de los documentos. Su dashboard permite consultar información sobre el estado de las operaciones, detectar errores y realizar seguimiento de variables como el porcentaje de procesamiento exitoso y el consumo de tokens.
Esta visibilidad permite pasar de una automatización que simplemente “funciona” a una operación que puede medirse, auditarse y optimizarse.
De la automatización a la calidad del dato
El objetivo de automatizar documentos no debería ser únicamente reducir el tiempo que una persona dedica a cargar información.
El dato que ingresa a un ERP puede alimentar procesos contables, fiscales, financieros, logísticos y comerciales. Por eso, un error en una etapa temprana puede trasladarse a diferentes áreas de la organización.
Una factura con información incorrecta, un total que no coincide con su detalle o un dato mal interpretado puede requerir controles posteriores, generar reprocesos o afectar la trazabilidad de una operación.
En este contexto, la automatización adquiere una segunda dimensión: la calidad del dato.
Javier Godino lo resume de esta manera:
“El verdadero valor de automatizar con DOCK-IA no está solamente en reducir el tiempo de carga, sino en mejorar el control sobre el dato que entra al sistema. La automatización tiene que incorporar validaciones antes de que esa información llegue a los sistemas transaccionales.”
Este enfoque resulta especialmente relevante para organizaciones que manejan grandes cantidades de documentación y necesitan conectar esos datos con sus sistemas core sin sumar tareas manuales en cada etapa.
Menos procesamiento innecesario, más control sobre la IA
El desarrollo de DOCK-IA parte de una premisa: no todo dato necesita ser procesado por inteligencia artificial.
Una arquitectura eficiente puede reservar los modelos de IA para aquellas situaciones en las que realmente aportan capacidad de interpretación, mientras que las tareas repetitivas y predecibles pueden resolverse mediante reglas.
Esto permite pensar el consumo de IA desde una perspectiva arquitectónica y no solamente como una cuestión de elección de modelo.
En una operación documental, el flujo puede resumirse así:
Documento → extracción por reglas → IA selectiva ante excepciones → validación → estructuración → integración con sistemas empresariales.
Para las empresas, el beneficio no se limita a la automatización. También implica mayor visibilidad sobre cómo se procesa la información, más control sobre los datos que llegan a los sistemas y una estrategia de utilización de IA que puede escalar junto con la operación.
¿Querés conocer cómo puede aplicarse DOCK-IA a los procesos documentales de tu empresa? Solicitá una demostración personalizada escribiendo a [email protected] y conoce cómo puede integrarse DOCK-IA a tu arquitectura tecnológica.